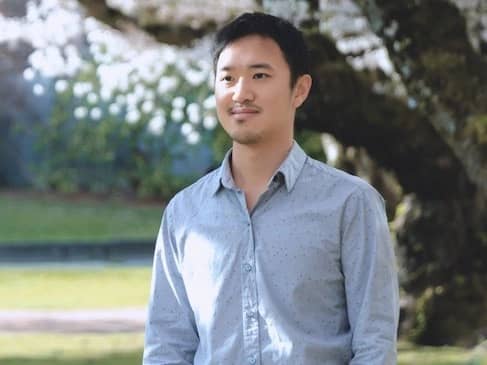
Yuanzhi Li
**위안즈 리(Yuanzhi Li)**는 카네기 멜론 대학교의 컴퓨터 과학자이자 컴퓨터 과학과 조교수로, 머신러닝 이론과 대규모 언어 모델 연구에 주력하고 있습니다. 그의 연구 분야는 딥러닝, 최적화, 그리고 대규모 언어 모델의 능력을 지배하는 메커니즘을 아우르며, 여러 기술 보고서의 공동 저자로서 마이크로소프트의 소형 언어 모델인 Phi 시리즈의 협력자로 활동해 왔습니다. 또한 그는 언어 모델이 지식을 저장하고 조작하는 방식을 연구하는 다부작 시리즈인 "언어 모델의 물리학(Physics of Language Models)"의 주요 저자이기도 합니다.[3][8][9][10]
학력
위안즈 리는 프린스턴 대학교에 진학하여 2018년에 컴퓨터 과학 박사 학위를 취득했습니다. 그의 박사 학위 논문 제목은 "경사 하강법의 신경망 학습 능력에 관하여(On the ability of gradient descent to learn neural networks)"로, 경사 기반 최적화 기법을 통한 신경망 훈련을 지배하는 이론적 원리를 조사했습니다.[1][3]
경력
리는 박사 학위 취득 후 스탠퍼드 대학교에서 박사후 연구원 과정을 마치며 현대 머신러닝의 이론적 측면을 연구했습니다. 2019년 카네기 멜론 대학교의 컴퓨터 과학과 조교수로 부임하여 딥러닝, 최적화 및 대규모 언어 모델의 이론과 실제에 집중해 왔습니다. 카네기 멜론에 재직하는 동안 그는 마이크로소프트 Phi 소형 언어 모델 제품군의 핵심 협력자로서 데이터 품질과 효율적인 확장을 강조하는 phi-1.5, Phi-3, Phi-4 등의 모델에 대한 기술 보고서를 공동 집필했으며, 언어 모델이 사실적 지식을 어떻게 저장, 추출 및 확장하는지에 대한 다부작 연구 프로그램인 "언어 모델의 물리학"을 공동 이끌었습니다.
2025년 7월, 언론 보도에 따르면 메타 플랫폼(Meta Platforms)이 고급 AI 시스템 구축을 목표로 신설된 Meta Superintelligence Labs에 기여하도록 위안즈 리를 영입 중인 것으로 알려졌으나, 해당 보도에서 그의 공식 직함이나 구체적인 책임 범위는 명시되지 않았습니다.[3][8][9][10][2][4]
연구 및 출판물
리의 연구는 머신러닝과 이론 컴퓨터 과학 내의 광범위한 주제를 다룹니다. 그의 작업은 종종 최적화 역학, 일반화, 특징 학습 및 대규모 언어 모델의 행동에 초점을 맞추어 딥러닝 모델의 메커니즘, 능력 및 한계에 대한 근본적인 질문에 답하고자 합니다. 그는 NeurIPS, ICML, ICLR, COLT, FOCS, STOC 등 저명한 컨퍼런스와 저널에 수많은 논문을 발표했으며, 언어 모델이 사실적 지식을 어떻게 표현, 검색 및 확장하는지 분석하는 다부작 프로그램인 "언어 모델의 물리학"의 주요 기여자입니다.[1][5][9][10]
딥러닝 이론
리의 연구 중 상당 부분은 신경망의 이론적 특성에 할애되어 있습니다. 그는 현대 딥러닝에서 흔히 볼 수 있는 과잉 매개변수화된(over-parameterized) 모델의 맥락에서 확률적 경사 하강법(SGD) 및 Adam과 같은 최적화 알고리즘의 수렴과 행동에 관한 기초적인 연구를 공동 집필했습니다. 이 분야에서 그의 연구는 최적화 알고리즘의 암묵적 편향, 훈련 결과를 결정하는 초기화 및 학습률의 역할, 적대적 강건성(adversarial robustness) 및 자기 지도 학습의 기초가 되는 메커니즘을 분석합니다. 이러한 기여를 반영하는 대표적인 출판물로는 "과잉 매개변수화를 통한 딥러닝의 수렴(Convergence) 이론", "역방향 특징 수정: 딥러닝이 심층(계층적) 학습을 수행하는 방법", "신경망 훈련에서 초기 큰 학습률의 정규화 효과 설명에 대하여" 등이 있습니다.[1][5]
대규모 언어 모델
최근 몇 년 동안 리는 추론 능력, 지식 표현 및 확장 동작을 포함한 대규모 언어 모델(LLM)의 원리와 창발적 능력에 집중해 왔습니다. 그는 2023년 논문 "인공 일반 지능의 불꽃(Sparks): GPT-4를 이용한 초기 실험"[11]의 공동 저자로, 이 논문은 모델의 고급 추론 및 문제 해결 능력을 분석하고 이러한 시스템이 광범위한 인지 기술을 보여준다고 주장했습니다. 또한 그는 LLM이 사실적 지식을 어떻게 저장하고 조직하는지, 그 지식을 어떻게 추출하고 조작할 수 있는지, 그리고 지식 용량이 모델 크기, 아키텍처 및 훈련 절차에 따라 어떻게 확장되는지 이해하기 위한 이론적 틀을 구축하는 것을 목표로 하는 "언어 모델의 물리학" 시리즈 논문의 공동 저자이기도 합니다.[9][10]
리는 "LoRA: 대규모 언어 모델의 저차원 적응(Low-Rank Adaptation of Large Language Models)" 논문을 공동 집필했습니다.[12] 이 연구는 거대한 사전 훈련된 모델을 특정 다운스트림 작업에 적응시키는 데 드는 계산 비용을 줄여주는 매개변수 효율적인 미세 조정 기법을 도입했으며, 이는 LLM의 실제 응용 분야에서 널리 채택되는 방법이 되었습니다.[1][5][6]
마이크로소프트 Phi 모델
리는 마이크로소프트 연구원들과 함께 Phi 소형 언어 모델 제품군 개발의 핵심 협력자로 활동해 왔습니다. 그는 "교과서만 있으면 된다(Textbooks Are All You Need)"(Phi-1의 개념 도입), "교과서만 있으면 된다 II: phi-1.5 기술 보고서", "Phi-3 기술 보고서", "Phi-4 기술 보고서"의 공동 저자로 등재되어 있습니다. 이 연구는 고품질의 "교과서 같은" 데이터로 훈련된 모델이 훨씬 더 큰 모델과 비슷하거나 심지어 능가하는 추론 및 언어 이해 벤치마크 성능을 달성할 수 있음을 보여주었습니다. 이 작업은 모델의 능력이 주로 규모(즉, 매개변수 수)의 함수라는 견해에 도전하고 훈련 데이터의 품질과 큐레이션의 중요성을 강조했습니다.
딥러닝 이론과 LLM에 대한 연구 외에도 리는 강화 학습, 생성 모델링, 볼록 최적화를 포함한 머신러닝의 다른 분야에도 기여했습니다. 이러한 영역에서의 그의 연구에는 생성적 적대 신경망(GAN)의 이론적 분석, 확산 모델(diffusion models)을 위한 이론 개발, 효율적인 밴딧(bandit) 알고리즘 설계 등이 포함됩니다. 이 분야의 대표적인 논문으로는 "샘플링은 점수를 배우는 것만큼 쉽다: 최소한의 데이터 가정을 가진 확산 모델을 위한 이론" 및 "강화 학습에서 샘플 복잡도의 수평선 의존성 해결" 등이 있습니다.[1][5][8]
인터뷰
Tiny Stories 데이터셋에 관한 토론
2023년 6월 6일, Cognitive Revolution 팟캐스트는 네이선 라벤츠(Nathan Labenz), 로넨 엘단(Ronen Eldan), 그리고 마이크로소프트 리서치의 위안즈 리가 참여하여 Tiny Stories 프로젝트에 대해 나눈 토론을 다루었습니다. 리는 이 프로젝트가 GPT-4와 GPT-3.5를 사용하여 생성된 약 150만 개의 어린이용 이야기로 구성된 합성 데이터셋을 포함한다고 설명했습니다. 이 데이터셋은 약 2,000개의 단순한 단어로 제한된 어휘를 사용하며, GPT-2 크기의 약 2%에 해당하는 100만 개에서 3,300만 개의 매개변수를 가진 소규모 언어 모델을 훈련할 수 있도록 설계되었습니다.
리에 따르면, 이 프로젝트는 문법, 사실 회상, 기본 논리 연산과 같은 핵심 언어 능력의 발달을 소규모 모델 내에서 조사할 수 있는 틀을 제공합니다. 그는 모델의 깊이는 추론 과정의 복잡성과 관련이 있는 반면, 모델의 너비는 사실적 정보에 대한 기억 용량과 연결되어 있다고 언급했습니다. 모델의 어텐션 메커니즘은 토큰 간의 위치 관계에 집중하는 '거리 헤드(distance heads)'와 콘텐츠 관련성을 우선시하는 '의미 헤드(semantic heads)'라는 두 가지 주요 패턴을 보이는 것으로 설명되었습니다.
리는 또한 추론 작업이 대규모 자연어 데이터셋에서는 상대적으로 드물며, 사실 암기와 모델 용량을 두고 경쟁할 수 있다고 지적했습니다. 그는 Tiny Stories 데이터셋이 언어 및 추론 기술을 구조화된 방식으로 도입하는 커리큘럼 학습의 한 형태를 적용하는 데 사용될 수 있다고 설명했습니다. 해석 가능성 측면에서 리는 소규모 모델이 뉴런과 어텐션 헤드의 기능을 더 명확하게 식별할 수 있게 해주는 반면, 대규모 모델은 기능을 더 많은 매개변수에 분산시켜 분석하기 어렵게 만든다고 밝혔습니다. 그는 모델의 실제적인 제어를 승마에 비유하며, 효과적인 사용을 위해 내부 과정을 완전히 이해할 필요는 없다고 말했습니다.
이 토론은 계산적으로 제한된 조건에서 언어 모델의 행동, 추론 능력 및 해석 가능성을 연구하기 위해 Tiny Stories 프레임워크가 어떻게 적용될 수 있는지 개략적으로 설명했습니다.[7]