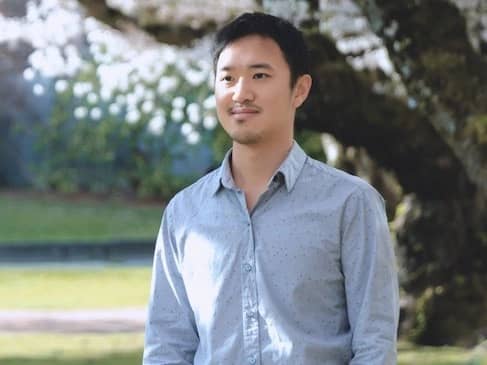
Yuanzhi Li
李远志(Yuanzhi Li)是一位计算机科学家,现任卡内基梅隆大学计算机科学系助理教授,其研究重点是机器学习理论和大型语言模型。他的工作涵盖深度学习、优化以及主导大型语言模型能力的机制。作为多份技术报告的共同作者,他曾参与微软 Phi 系列小语言模型的协作开发。他也是多部分研究系列“语言模型物理学”(Physics of Language Models)的主要作者,该系列研究了语言模型如何存储和处理知识。[3][8][9][10]
教育经历
李远志就读于普林斯顿大学,并于 2018 年获得计算机科学博士学位。他的博士论文题目为《论梯度下降学习神经网络的能力》(On the ability of gradient descent to learn neural networks),探讨了通过基于梯度的优化技术训练神经网络的理论原理。[1][3]
职业生涯
在获得博士学位后,李远志在斯坦福大学完成了博士后研究,致力于现代机器学习的理论方面。他于 2019 年加入卡内基梅隆大学担任计算机科学助理教授,专注于深度学习、优化和大型语言模型的理论与实践。在卡内基梅隆大学任职期间,他一直是微软 Phi 系列小语言模型的核心合作者,共同撰写了包括 phi-1.5、Phi-3 和 Phi-4 在内的模型技术报告,这些报告强调数据质量和高效扩展。此外,他还共同领导了关于语言模型如何存储、提取和扩展事实知识的多部分“语言模型物理学”研究项目。
2025 年 7 月,媒体报道称 Meta Platforms 正在招募李远志加入其新成立的 Meta 超级智能实验室(Meta Superintelligence Labs),该实验室旨在构建先进的 AI 系统,尽管这些报道并未明确其正式头衔或具体职责。[3][8][9][10][2][4]
研究与出版物
李远志的研究涵盖了机器学习和理论计算机科学领域的广泛课题。他的工作通常旨在回答有关深度学习模型机制、能力和局限性的基本问题,重点关注优化动力学、泛化、特征学习以及大型语言模型的行为。他在 NeurIPS、ICML、ICLR、COLT、FOCS 和 STOC 等知名会议和期刊上发表了大量论文,并且是多部分“语言模型物理学”项目的主要贡献者,该项目分析了语言模型如何表示、检索和扩展事实知识。[1][5][9][10]
深度学习理论
李远志研究的很大一部分致力于神经网络的理论特性。他共同撰写了关于随机梯度下降(SGD)和 Adam 等优化算法的收敛性和行为的基础性工作,特别是在现代深度学习中常见的过度参数化模型背景下。他在该领域的研究分析了优化算法的隐式偏差、初始化和学习率在决定训练结果中的作用,以及对抗鲁棒性和自我监督学习的底层机制。反映这些贡献的代表性出版物包括《通过过度参数化实现的深度学习收敛理论》(A Convergence Theory for Deep Learning via Over-Parameterization)、《后向特征修正:深度学习如何执行深度(分层)学习》(Backward Feature Correction: How Deep Learning Performs Deep (Hierarchical) Learning)以及《旨在解释神经网络训练中初始大学习率的正则化效应》(Towards Explaining the Regularization Effect of Initial Large Learning Rate in Training Neural Networks)。[1][5]
大型语言模型
近年来,李远志专注于大型语言模型(LLM)的原理和涌现能力,包括它们的推理能力、知识表示和扩展行为。他是 2023 年论文《通用人工智能的火花:GPT-4 的早期实验》(Sparks of Artificial General Intelligence: Early experiments with GPT-4)的共同作者,[11] 该论文分析了该模型的高级推理和问题解决能力,并认为此类系统展示了广泛的认知技能。他也是“语言模型物理学”系列论文的共同作者,该系列旨在建立一个理论框架,以理解 LLM 如何存储和组织事实知识,如何提取和处理这些知识,以及知识容量如何随模型大小、架构和训练程序而扩展。[9][10]
李远志共同撰写了论文《LoRA:大型语言模型的低秩自适应》(LoRA: Low-Rank Adaptation of Large Language Models)。[12] 这项工作引入了一种参数高效的微调技术,降低了将大型预训练模型适配到特定下游任务的计算成本,并已成为 LLM 实际应用中广泛采用的方法。[1][5][6]
微软 Phi 模型
李远志一直是与微软研究人员合作开发 Phi 系列小语言模型的核心成员。他是《教科书就是你所需要的一切》(Textbooks Are All You Need,介绍了 Phi-1 背后的概念)、《教科书就是你所需要的一切 II:phi-1.5 技术报告》、《Phi-3 技术报告》和《Phi-4 技术报告》的共同作者。这项研究表明,在高质量、“教科书式”数据上训练的模型,在推理和语言理解基准测试中可以达到与大得多的模型相当甚至超过其的表现。这项工作挑战了模型能力主要取决于规模(即参数数量)的观点,并强调了训练数据质量和策划的重要性。
除了在深度学习理论和 LLM 方面的工作外,李远志还对机器学习的其他领域做出了贡献,包括强化学习、生成建模和凸优化。他在这些领域的研究包括对生成对抗网络(GAN)的理论分析、扩散模型理论的发展以及高效老虎机算法的设计。这些领域的代表性论文包括《采样与学习评分一样简单:具有最小数据假设的扩散模型理论》(Sampling is as easy as learning the score: theory for diffusion models with minimal data assumptions)和《解决强化学习中样本复杂度的视界依赖性》(Settling the Horizon-Dependence of Sample Complexity in Reinforcement Learning)。[1][5][8]
访谈
关于 Tiny Stories 数据集的讨论
2023 年 6 月 6 日,《认知革命》(Cognitive Revolution)播客节目邀请了 Nathan Labenz、Ronen Eldan 以及微软研究院的李远志,就 Tiny Stories 项目进行了讨论。李远志解释说,该项目涉及一个由 GPT-4 和 GPT-3.5 生成的约 150 万个儿童故事组成的合成数据集。该数据集使用了约 2,000 个简单词汇的受限词汇表,旨在支持训练参数范围从 100 万到 3,300 万的小规模语言模型,这大约仅为 GPT-2 规模的 2%。
据李远志介绍,该项目提供了一个框架,用于检查较小模型中核心语言能力(如语法、事实召回和基本逻辑运算)的发展。他指出,模型深度与推理过程的复杂性相关,而模型宽度则与事实信息的记忆容量相关。模型的注意力机制被描述为表现出两种主要模式:“距离头”(distance heads),关注标记之间的位置关系;以及“语义头”(semantic heads),优先考虑内容相关性。
李远志还指出,推理任务在大规模自然语言数据集中相对少见,并且可能会与事实记忆竞争模型容量。他解释说,Tiny Stories 数据集可用于应用一种课程学习形式,其中语言和推理技能以结构化的方式引入。在可解释性方面,李远志表示,较小的模型往往能更清晰地识别神经元和注意力头的功能,而较大的模型则将功能分布在更多参数中,使其更难分析。他将对模型的实际控制比作骑马,有效的利用并不需要完全理解其内部过程。
讨论概述了如何应用 Tiny Stories 框架来研究计算受限条件下语言模型的行为、推理能力和可解释性。[7]